Le moment décisif d’un déploiement d’IA physique, c’est celui où le travail peut continuer sans vous.
L’IA physique ouvre la voie à des capacités robotiques toujours plus variées. Les démonstrations montrent des robots qui apprennent à saisir des objets, à manipuler des matériaux inconnus et à réaliser des tâches qui semblaient autrefois hors de portée. Le prochain défi consiste à transformer ces capacités en travail utile sur le site d’un client.
Chez Gobano, c’est notre objectif : déployer des robots qui travaillent en autonomie. Le robot doit répéter sa tâche sans qu’une personne dirige chaque action ou supervise chaque cycle. Dans une blanchisserie, les serviettes bougent, les prises peuvent échouer et les conditions varient. La station doit gérer les erreurs qu’elle sait résoudre, récupérer et poursuivre le travail, pour qu’un salarié puisse se consacrer à une autre activité au lieu de rester aux commandes.
Nous partageons ici notre expérience de ce déploiement en blanchisserie et le jalon atteint : des heures de travail autonome aux côtés de l’équipe du client. Nous expliquons ce qui permet à la station de continuer à fonctionner, ses performances actuelles et la manière dont nous construisons la suite.
Un nouveau collègue dans la blanchisserie
Dès le premier jour, la station contribue à la production et permet aux salariés de se concentrer sur d’autres tâches. Elle prend en charge la manipulation répétitive des serviettes aux côtés de l’équipe en place.
Son autonomie porte sur cette tâche. Les salariés assurent la circulation des matières, l’approvisionnement de la station, la maintenance et le fonctionnement de l’ensemble de l’atelier. Ils gèrent également les incidents que le robot ne peut pas résoudre. Ce qui change, c’est qu’ils n’ont plus besoin de diriger chaque mouvement ni de superviser chaque cycle.
Pour le client, le bénéfice est concret : le travail répétitif peut continuer pendant que l’équipe s’occupe du reste de la blanchisserie. La station doit gagner sa place grâce à une production utile et à une répartition claire des responsabilités.
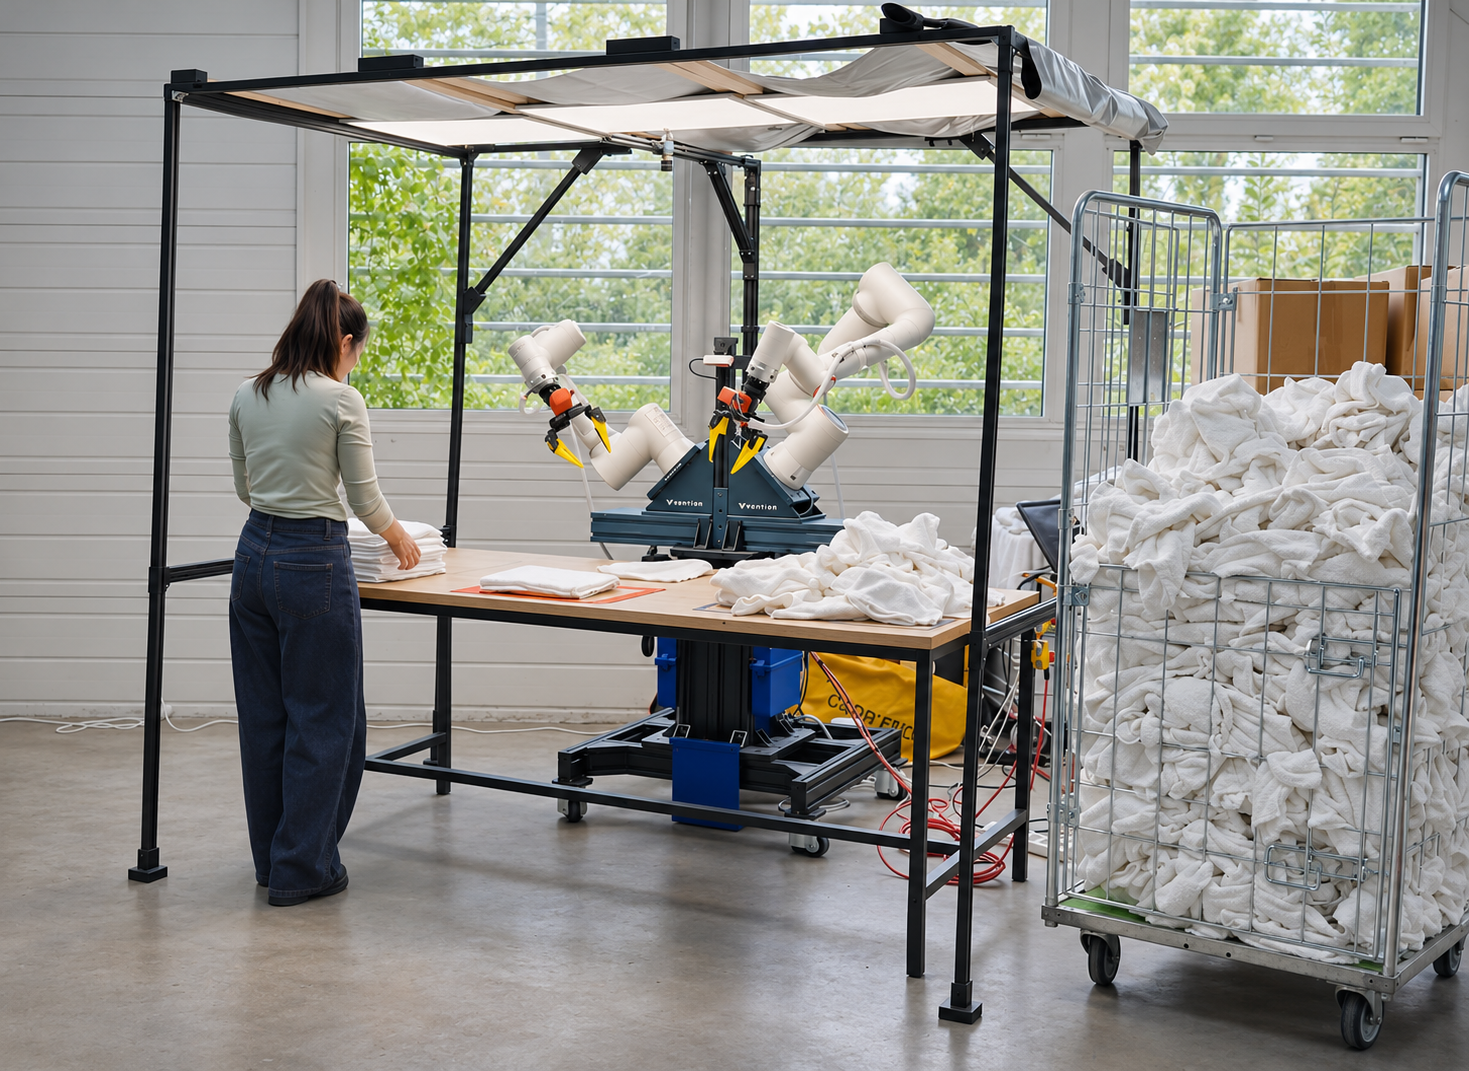
Être fiable, c’est permettre au travail de continuer
Manipuler un vêtement ou une serviette avec une pince robotique peut provoquer des incidents : le tissu se déforme, se plie et glisse pendant le mouvement. Une prise peut échouer ou saisir plusieurs épaisseurs, et un article peut se retrouver dans une position inattendue. Un mouvement qui a fonctionné au cycle précédent peut nécessiter une nouvelle tentative au suivant. Gérer ces variations fait partie du travail.
La récupération autonome permet à la station de réagir à ces difficultés et de reprendre sa tâche. Une tentative infructueuse que le robot résout lui-même n’a pas la même conséquence qu’un arrêt obligeant un salarié à interrompre son activité. C’est pourquoi la réussite d’une tâche et l’autonomie doivent être mesurées séparément.
La mesure pertinente du progrès, c’est le travail accompli entre deux interventions humaines.
La récupération prend néanmoins du temps. L’objectif opérationnel est d’accomplir davantage de travail utile entre deux interventions, avec moins de tentatives répétées et moins de temps consacré à la récupération. La mesure du débit doit inclure ce temps pour refléter la production réelle de la station.
Dans les coulisses : réduire les échecs grâce au Reinforcement Learning
Une serviette change de forme lorsqu’elle est saisie et déplacée. Sa position, ses plis et son contact avec la pince influencent la suite. Le contrôleur doit réagir tout au long de la tâche plutôt que rejouer une séquence fixe de mouvements.
Lors de la présentation de Toutatis, notre moteur de Reinforcement Learning, nous avons expliqué notre approche. Les démonstrations humaines apportent une capacité initiale. Un modèle du monde spécifique à la tâche représente la scène et sa dynamique. Le Reinforcement Learning utilise ensuite l’expérience du robot pour améliorer sa politique de contrôle en fonction des objectifs opérationnels.
La priorité est d’atteindre le niveau de fiabilité requis, puis d’augmenter le débit en le préservant. Un mouvement plus rapide a de la valeur s’il permet d’accomplir davantage de travail sans augmenter le besoin d’intervention humaine.
La politique apprise n’est qu’une composante du système. Elle doit fonctionner avec les capteurs, les pinces, l’enchaînement des étapes et la récupération. C’est leur intégration qui transforme une compétence apprise en une station capable de continuer à travailler sur le site d’un client.
Chaque période de travail nous donne de nouvelles pistes d’amélioration.
Une fois la station autonome, le défi suivant consiste à augmenter sa production utile. Le fonctionnement en production révèle où le temps se perd : tentatives répétées, mouvements lents et récupérations plus longues que nécessaire.
Les démonstrations montrent comment une personne réalise la tâche. Le fonctionnement autonome apporte des données sur le comportement du robot lui-même, notamment les échecs et les situations inhabituelles qui limitent ses performances. Ces observations nous aident à choisir les prochains objectifs d’entraînement.
Un travail autonome utile
Réussites, récupérations, temps de cycle
Évaluer la fiabilité et le débit
Nous transmettons cette expérience à Toutatis dans une boucle ciblée : identifier le point de blocage, entraîner une meilleure politique, l’évaluer et la redéployer. La comparaison doit prendre en compte le travail accompli, le temps de récupération et les interventions humaines. Un gain de vitesse qui provoque davantage d’arrêts n’est pas une amélioration opérationnelle.
C’est l’intérêt de cette boucle d’apprentissage à partir de la production : relier l’expérience à un échec ou à un retard précis, puis l’utiliser pour viser une amélioration mesurable. Plus la station accomplit de cycles, plus elle crée d’occasions d’apprendre. Chaque mise à jour doit démontrer son intérêt par de meilleures performances sur le terrain.
Une tâche aujourd’hui. Des robots plus capables demain.
Un robot autonome prend désormais en charge une tâche répétitive dans une vraie blanchisserie, aux côtés des personnes qui la font fonctionner. Voilà à quoi ressemble un déploiement réussi d’IA physique en 2026. Les enseignements tirés du terrain sont précieux : ils révèlent ce qui rend l’autonomie utile en pratique et ce qui permet de la maintenir.
Pour nous, chez Gobano, ce n’est pas un aboutissement, mais une première étape. Nos prochains objectifs sont concrets : des périodes d’autonomie plus longues, une production utile accrue et la capacité de traiter une plus grande variété de matériaux et de tâches.
Nous voulons que chaque nouveau robot bénéficie des échecs, des récupérations et des comportements réussis déjà rencontrés. Rendre cet apprentissage réutilisable d’un déploiement à l’autre, c’est ainsi que nous apporterons des robots plus intelligents et plus capables dans les ateliers industriels.
Nous nous sommes éloignés. Notre robot autonome a continué à travailler.
Nous construisons maintenant ce qu’il pourra accomplir ensuite.